Anzeige der Dubletten-Anzahl im Info-Zentrale

Hallo,

ich möchte gerne die Anzahl der Personen-Dubletten in der Info-Zentrale anzeigen. Über InvokeMenu müsste man aber zur Personenansicht wechseln und die SDK-Funktion FindRecordByDupeCheckCriteria liefert ja keine Gesamtzahl. Gibt es eine Alternative?

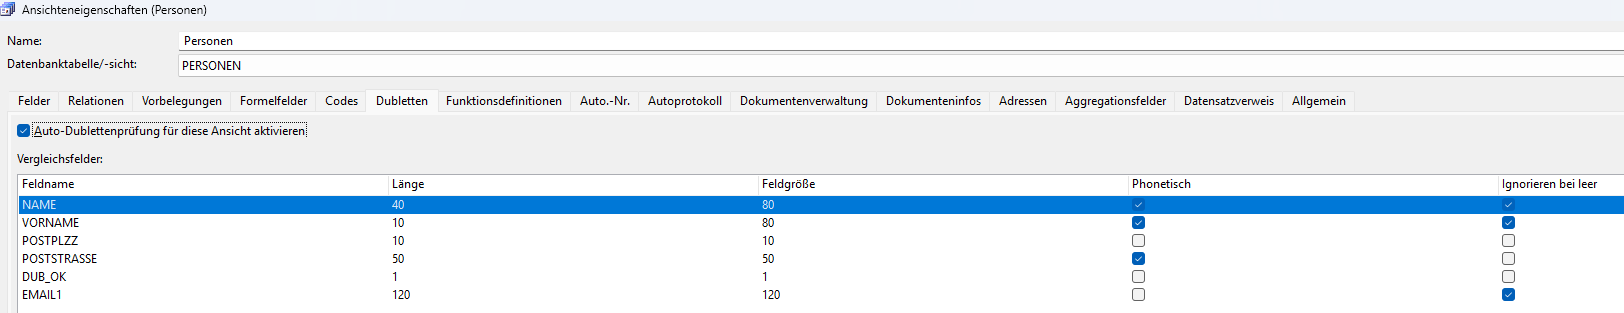
Damit wir Ihnen weiterhelfen können, bräuchte ich mal kurz noch nen Screenshot der „Dubletten“-Seite aus dem Eigenschaften-Dialog der Ansicht, in der gefiltert werden soll, und die Anzahl von Datensätzen, die Sie in der Ansicht circa haben. Dann schauen wir mal, was wir tun können. :slight_smile:

Aktuell sind es im Testsystem ca. 170 Dubletten, im Produktivsystem 0.

Danke!

Missverständnis: wie viele Datensätze sind ÜBERHAUPT in der Ansicht? (Ich klär den Hintergrund der Frage noch auf :handshake:)

Ah, insgesamt sind es knapp 70.000 Personen.

Ich lass direkt die Hosen runter: ich möchte Ihnen Ihre Idee unbedingt ausreden! :face_with_hand_over_mouth:

Ein Dublettenfilter ist eine brutale Last für Ihren Datenbankserver: er muss zur Berechnung des Ergebnisses ja jeden Datensatz mit jedem anderen Datensatz der Tabelle vergleichen. Der Aufwand wächst quadratisch mit der Anzahl der Datensätze. Sie haben 70.000 Datensätze. Dann sind das 4,9 MILLIARDEN Vergleiche, die Sie dem Datenbankserver abringen!! :anxious_face_with_sweat:

Zusätzlich muss die Abfrage zur Ermittlung der Datensatzanzahl dann gerade noch ein zweites Mal gemacht werden (select count(*) from ... where <Dublettenbedingungen>), es gibt keine Möglichkeit, dass der Datenbankserver beides in einem Schritt liefert und es gibt in combit CRM in der API auch keine Möglichkeit, „nur“ die Anzahl zu erfragen, ohne vorher auch den Filter dazu zu machen. (Da könnten wir evtl. mal noch was tricksen.)

Wenn Sie diesen Wert also in der Infozentrale darstellen, dann wird er bei JEDEM Aktualisieren der Info-Zentrale (je nach Implementierung der Info-Zentrale haben manche Kunden sogar absichtlich einen Timer, der zyklisch in der Info-Zentrale ein Refresh auslöst wg. neuen Bestellungen oder Anfragen o.ä.), außerdem natürlich bei jedem Öffnen der Info-Zentrale, also vermutlich bei jedem Start der Anwendung, diese Last auf dem Datenbankserver erzeugt. :scream: Wenn alle Anwender:innen diese Info-Zentrale sehen, dann auch noch multipliziert mit der Anzahl der Anwender:innen.

Daher meine dringende Bitte: Bitte lassen Sie es - die Performance Ihres Systems wird es Ihnen danken. :folded_hands: (Ich fände es schlimm, dass dann das combit CRM System bei den Anwender:innen als lahm :snail: wahrgenommen wird, obwohl wir gar nichts dafür können.)

Vorschlag: Sie könnten einen Button in „Personen“ (oder im Aktionen-Panel) spendieren: „Wie viele Dubletten gibt es aktuell?“ und BEIM KLICK dann die Ermittlung erst machen und das Ergebnis per Messagebox anzeigen, dann ist es wenigstens nur interaktiv „on demand“ 1 x.

Zur eigentlichen Frage: der Dublettenfilter ist natürlich eine „ganz normale“ SQL-Abfrage, die Sie auch als freie SQL-Abfrage für ein RecordSet-Objekt selbst in einem Script anwenden können. Und anschließend fragen Sie denn die RecCount-Eigenschaft des RecordSets ab und haben das Ergebnis:

' SQL Abfrage für Dublettenprüfung
sDupeSQL = _
" SELECT ""PERSONEN"".""ID"" FROM ""PERSONEN"" WHERE (EXISTS (SELECT 'Results!' FROM ""PERSONEN"" ""Y""" &_
" WHERE (""PERSONEN"".""ID"" <> ""Y"".""ID""" &_
" AND (ISNULL(SOUNDEX(""PERSONEN"".""NAME""),'') = ISNULL(SOUNDEX(""Y"".""NAME""),'') AND ""PERSONEN"".""NAME"" IS NOT NULL AND LEN(RTRIM(""PERSONEN"".""NAME"")) > 0)" &_
" AND (ISNULL(SOUNDEX(""PERSONEN"".""VORNAME""),'') = ISNULL(SOUNDEX(""Y"".""VORNAME""),'') AND ""PERSONEN"".""VORNAME"" IS NOT NULL AND LEN(RTRIM(""PERSONEN"".""VORNAME"")) > 0)" &_
" AND (ISNULL(""PERSONEN"".""POSTPLZZ"",'') = ISNULL(""Y"".""POSTPLZZ"",''))" &_
" AND (ISNULL(SOUNDEX(""PERSONEN"".""POSTSTRASSE""),'') = ISNULL(SOUNDEX(""Y"".""POSTSTRASSE""),''))" &_
" AND (ISNULL(""PERSONEN"".""DUB_OK"",'') = ISNULL(""Y"".""DUB_OK"",''))" &_
" AND (ISNULL(""PERSONEN"".""EMAIL1"",'') = ISNULL(""Y"".""EMAIL1"",'') AND ""PERSONEN"".""EMAIL1"" IS NOT NULL AND LEN(RTRIM(""PERSONEN"".""EMAIL1"")) > 0))" &_
" AND (""Y"".""RecycleBinID"" IS NULL))) AND (""PERSONEN"".""RecycleBinID"" IS NULL)"

nNumberOfDupes = 0
set oRecordSetWithDupes = cRM.CurrentProject.ViewConfigs.ItemByName("Personen").CreateRecordSet("SetFilterDirectSQL:" & sDupeSQL)
if (not oRecordSetWithDupes is nothing) then
   nNumberOfDupes = oRecordSetWithDupes.RecCount
end if
set oRecordSetWithDupes  = Nothing

MsgBox nNumberOfDupes & " gefunden."

Disclaimer: der SQL-Code ist ungetestet, da er auf Ihren Tabellen- und Spaltennamen basiert, die uns nicht vorliegen.

TODO: Falls Ihre Primärschlüssel/Datensatz-ID-Spalte nicht „ID“ heißt, müssen Sie in der sDupeSQL-Zeichenkette überall, wo ID steht (3 Stellen), anstattdessen Ihren Spaltennamen eintragen.

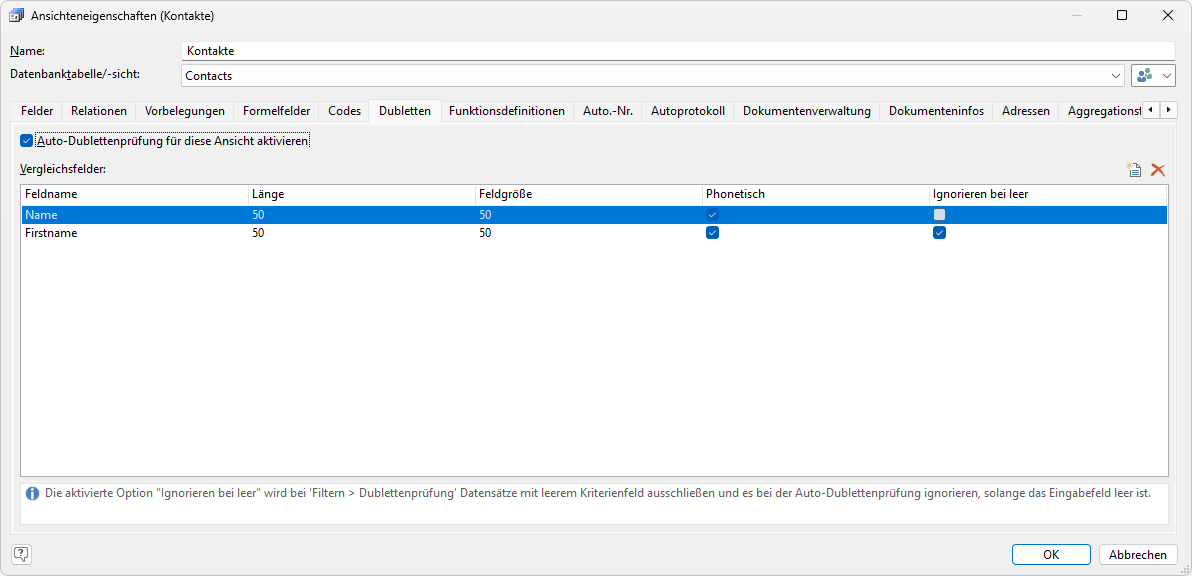
Hier ein getestetes Beispiel basiend auf der Large-Solution („Kontakte“) mit nur zwei Dublettenkriterien:

nNumberOfDupes = 0

' SQL Abfrage für Dublettenprüfung (Name phonetisch, Vorname phonetisch, Vorname wird ignoriert wenn leer, Kontakte im Papierkorb ignorieren)
sDupeSQL = _
"SELECT ""Contacts"".""ID"" FROM ""Contacts"" WHERE (EXISTS (SELECT 'Results!' FROM ""Contacts"" ""Y""" &_
" WHERE (""Contacts"".""ID"" <> ""Y"".""ID""" &_
" AND ((ISNULL(SOUNDEX(""Contacts"".""Name""),'') = ISNULL(SOUNDEX(""Y"".""Name""),''))" &_
" AND ((ISNULL(SOUNDEX(""Contacts"".""Firstname""),'') = ISNULL(SOUNDEX(""Y"".""Firstname""),'') AND ""Contacts"".""Firstname"" IS NOT NULL AND LEN(RTRIM(""Contacts"".""Firstname"")) > 0))))" &_
" AND (""Y"".""RecycleBinID"" IS NULL))) AND (""Contacts"".""RecycleBinID"" IS NULL)"

set oRecordSetWithDupes = cRM.CurrentProject.ViewConfigs.ItemByName("Kontakte").CreateRecordSet("SetFilterDirectSQL:" & sDupeSQL)
if (not oRecordSetWithDupes is nothing) then
   nNumberOfDupes = oRecordSetWithDupes.RecCount
end if
set oRecordSetWithDupes  = Nothing

MsgBox nNumberOfDupes & " gefunden."

Also: den Vergleich soooo vieler Datensätze hätte ich niemals programmiert - aber die Lösung mit dem SQL-Filter ist schon genial. Und den dürfte man doch bei der Aktualisierung der Info-Zentrale problemlos ausführen, oder?!
Ihre SQL-Strings führten bei mir leider immer zu Nothing als RecordSet, aber dieser hier tut es:

sDupeSQL = \_
"SELECT PERSONEN.SID_PERSONEN" &\_
" FROM PERSONEN" &\_
" WHERE EXISTS (" &\_
"    SELECT 'Results!'" &\_
"    FROM PERSONEN Y" &\_
"    WHERE PERSONEN.SID_PERSONEN <> Y.SID_PERSONEN" &\_
"    AND (ISNULL(SOUNDEX(PERSONEN.NAME), '') = ISNULL(SOUNDEX(Y.NAME), '') AND PERSONEN.NAME IS NOT NULL AND LEN(RTRIM(PERSONEN.NAME)) > 0)" &\_
"    AND (ISNULL(SOUNDEX(PERSONEN.VORNAME), '') = ISNULL(SOUNDEX(Y.VORNAME), '') AND PERSONEN.VORNAME IS NOT NULL AND LEN(RTRIM(PERSONEN.VORNAME)) > 0)" &\_
"    AND (ISNULL(PERSONEN.POSTPLZZ, '') = ISNULL(Y.POSTPLZZ, ''))" &\_
"    AND (ISNULL(SOUNDEX(PERSONEN.POSTSTRASSE), '') = ISNULL(SOUNDEX(Y.POSTSTRASSE), ''))" &\_
"    AND (ISNULL(PERSONEN.DUB_OK, '') = ISNULL(Y.DUB_OK, ''))" &\_
"    AND (ISNULL(PERSONEN.EMAIL1, '') = ISNULL(Y.EMAIL1, '') AND PERSONEN.EMAIL1 IS NOT NULL AND LEN(RTRIM(PERSONEN.EMAIL1)) > 0))"

Liegt das an den Anführungszeichen?
Egal, das ist die Lösung - es gibt die exakte Zahl an Dubletten wie beim Menüaufruf.

Danke!

Mit dem SQL Filter zwingen Sie den Server diese Milliarden an Vergleichen zu tun. Gucken Sie mal am Server wie die Last hoch geht in dem Augenblick. In der Zeit hat er vereinfacht ausgedrückt auch Probleme, andere User zu bedienen. Und das ganze passiert dann bei jedem popeligen Reload der Infozentrale und zwar ausgelöst durch jeden User. Immer und immer wieder zig mal. Bitte nicht…

Legen Sie das Script im Workflowserver auf ein tägliches Ereignis abends um 19.00 und es soll Ihnen die Anzahl Duplikate per Mail schicken wenn es mehr als 0 sind. Fertig.

(Warum unsere Abfrage nicht geht, wenn Sie ID durch Ihre SID_PERSONEN an den 3 Stellen ersetzen, erschließt sich mir grad nicht, aber ich habe ehrlich gesagt auch gerade keine Ressourcen, das weiter zu verfolgen.)

Alles klar, dann lasse ich das mit der Info-Zentrale. Eine Benachrichtigung der zuständigen Personen ist eine gute Alternative.
Vielen Dank noch einmal!

Update: mit Update 13.5 wird es eine neue Methode FilterRecCount geben, mit der die Anzahl von Datensätzen für einen übergebenen Filter direkt ermittelt wird, ohne dass dazu der Filter erst einmal auf das RecordSet angewendet werden muss:

sDupeSQL = "SELECT ""Contacts"".""ID"" FROM ..."
nNumberOfDupes = 0
set oRecordSet = cRM.CurrentProject.ViewConfigs.ItemByName("Kontakte").CreateRecordSet
nNumberOfDupes = oRecordSet.FilterRecCount("SetFilterDirectSQL:" & sDupeSQL)    'ERSTE UND EINZIGE QUERY (mit select count(*))
if (nNumberOfDupes = -1) then
    MsgBox "Fehlerhafter Filter!"
end if
set oRecordSet  = Nothing

MsgBox nNumberOfDupes & "Dubletten gefunden."

Damit kommt das ganze Konstrukt mit nur noch 1 Abfrage aus. :tada:

(Bitte trotzdem nicht in Echtzeit in der Info-Zentrale kontinuierlich abrufen :smiling_face:)

Es bleibt bei der Best-Practice-Empfehlung, dass wo immer möglich auf RecCount (und FilterRecCount) verzichtet werden sollte, wenn der Filter tatsächlich angewendet wird, weil mit dem gefilterten RecordSet gearbeitet werden soll. Für die Prüfung, OB ÜBERHAUPT Ergebnisse vorliegen, wird der Rückgabewert von oRecordSet.MoveFirst geprüft, wenn es darum geht, zu unterscheiden, ob es genau 1 Treffer oder mehrere gibt, nutzt man die Eigenschaft oRecordSet.HasMultipleRecords. :horse: :dashing_away:

Das ist doch mal eine gute Nachricht und eine coole Funktion!

SELECT PERSONEN.SID_PERSONEN
FROM PERSONEN
WHERE EXISTS (
    SELECT 'Results!'
    FROM PERSONEN Y
    WHERE PERSONEN.SID_PERSONEN <> Y.SID_PERSONEN
    AND (ISNULL(SOUNDEX(PERSONEN.NAME), '') = ISNULL(SOUNDEX(Y.NAME), '') AND PERSONEN.NAME IS NOT NULL AND LEN(RTRIM(PERSONEN.NAME)) > 0)
    AND (ISNULL(SOUNDEX(PERSONEN.VORNAME), '') = ISNULL(SOUNDEX(Y.VORNAME), '') AND PERSONEN.VORNAME IS NOT NULL AND LEN(RTRIM(PERSONEN.VORNAME)) > 0)
    AND (ISNULL(PERSONEN.POSTPLZZ, '') = ISNULL(Y.POSTPLZZ, ''))
    AND (ISNULL(SOUNDEX(PERSONEN.POSTSTRASSE), '') = ISNULL(SOUNDEX(Y.POSTSTRASSE), ''))
    AND (ISNULL(PERSONEN.DUB_OK, '') = ISNULL(Y.DUB_OK, ''))
    AND (ISNULL(PERSONEN.EMAIL1, '') = ISNULL(Y.EMAIL1, '') AND PERSONEN.EMAIL1 IS NOT NULL AND LEN(RTRIM(PERSONEN.EMAIL1)) > 0))

Ich finde das Thema Dubletten ganz interessant aus Datenbank-Sicht. Das SQL scheint mir hier eher suboptimal. Zum einen, weil durch SOUNDEX() das Recordset ja durchaus größer wird, als bei einem exakten Vergleich. Im Gegenzug wird es durch den Ausschluss von z.B. VORNAME IS NULL wieder rum kleiner. Wenn ich einen Michael Meyer habe und einen Meyer, dann könnten das ja auch die selben Personen sein. Jetzt könnte man natürlich sagen, Meyer gibt es halt oft, ist erstmal unwahrscheinlich. Aber es fließen ja einige Spalten in die Bewertung ein, z.B. auch die Postadresse. Die hätte ich persönlich eher raus gelassen aber wo sie schonmal drin ist, erscheint es mir gar nicht so unwahrscheinlich, das Michael Meyer und Meyer die selbe Person sind. Und SOUNDEX() zeigt ja, das man das eher weit gefasst betrachten will.

Ich würde daher überlegen, wo ich hin will. Will ich möglichst viele, potenzielle Dubletten aufspüren, muss ich NULL-Werte tendenziell eher auch berücksichtigen. Ansonsten wäre mir SOUNDEX() zu weit gefasst. Wenn es z.B. nur darum geht ss und ß gleich zu setzen, dann macht SQL das mit der richtigen COLLATION ggf. von allein bzw. man kann die COLLATION noch im SELECT bestimmen - kurz: es gibt andere Möglichkeiten.

Auch wird es Situationen geben, da gibt es eine Person wirklich „doppelt“ aus DB-Sicht. Und man hat vielleicht das entscheidende Attribut nicht, was die Personen unterscheidet z.B. Geburtsdatum). Für diesen Fall sollte man eine Markierung oder einen anderen Mechanismus vorsehen, der diese Fälle nach einer Prüfung fest hält und von der Dubletten-Suche ausnimmt.

Praktisch würde schon ein BIT reichen, das an einem von zwei Datensätzen gesetzt ist. Die Prüfung erfolgt dann auf „Beide Datensätze haben BIT nicht gesetzt“ und beide Datensätze fallen aus der Suche. Kommt ein dritter hinzu, gibt es zumindest wieder zwei Dubletten, also Datensatz A und C weil B markiert ist. Keine optimale aber eine einfache Lösung. (Sofern nicht z.B. Datensatz A einer Löschung unterworfen werden kann, dann muss man vielleicht umdenken weil B und C nicht gematcht werden.)

Auf die Überlegung gekommen bin ich überhaupt erst durch den Versuch, die Performance zu verbessern. Grundsätzlich würde ich @Björn Eggstein immer zustimmen, diese Abfrage hat auf einer Übersichtsseite nichts verloren - weniger ist mehr. Zumal die draus gewonnene Information vermutlich nur in ganz bestimmten Situationen gebracht werden. Dennoch ist bei der Performance deutlich mehr drin.

Der Ansatz mit EXISTS() ist ja durchaus logisch und wird auch auf alten SQL Systemen fast immer unterstützt. Manchmal lohnt es sich aber auch, Features wie z.B. Window-Funktionen in SQL zu nutzen. Die kann MSSQL auch schon lange und die sind ein mächtiges Werkzeug. Ich würde daher eine Variante ins Spiel bringen, die sich auch durch recht schlanken Code auszeichnet (pro Spalte) und deutlich schneller läuft bei mir.

SELECT	PERSONEN.SID_PERSONEN
FROM	PERSONEN
WHERE	EXISTS (

SELECT 'Results!'
FROM	PERSONEN Y
WHERE	PERSONEN.SID_PERSONEN <> Y.SID_PERSONEN
AND (ISNULL(SOUNDEX(PERSONEN.NAME), '') = ISNULL(SOUNDEX(Y.NAME), '') AND PERSONEN.NAME IS NOT NULL AND LEN(RTRIM(PERSONEN.NAME)) > 0)
AND (ISNULL(SOUNDEX(PERSONEN.VORNAME), '') = ISNULL(SOUNDEX(Y.VORNAME), '') AND PERSONEN.VORNAME IS NOT NULL AND LEN(RTRIM(PERSONEN.VORNAME)) > 0)
AND (ISNULL(PERSONEN.ANREDE, '') = ISNULL(Y.ANREDE, '') AND PERSONEN.ANREDE IS NOT NULL AND LEN(RTRIM(PERSONEN.ANREDE)) > 0));

8.288 potenzielle Dubletten von 31.162 Datensätzen, Laufzeit 272 ms.

SELECT	SID_PERSONEN
FROM	(

SELECT	*, count(*) 
OVER (PARTITION BY soundex(NAME),soundex(VORNAME),ANREDE) AS x
FROM	PERSONEN

) xx

WHERE	xx.x > 1;

8.386 potenzielle Dubletten von 31.162 Datensätzen, Laufzeit 104 ms.

Die Differenz in den Treffern erklärt sich durch die Behandlung von NULL-Werten, bei mir gibt es da durchaus den ein oder Anderen. Ich habe darüber gegrübelt, wie man das 1:1 hin bekommt, bin dann aber allgemein damit nicht glücklich geworden und denke auch, dass das erstmal nicht ausschlaggebend ist.

Ich habe noch eine log-Tabelle nach dem gleichen Prinzip getestet, weil ich mehr Datensätze wollte. Mit den Spalten, die ich verglichen habe, gab es dabei unsinnig viele Dubletten aber die Laufzeit dürfte sich vor allem auf die Anzahl der Datensätze allgemein beziehen.

Variante mit EXISTS(): 88.646 potenzielle Dubletten von 88.648 Datensätzen, Laufzeit 2401 ms.

Variante mit Window-Funktion: 88.646 potenzielle Dubletten von 88.648 Datensätzen, Laufzeit 673 ms.

Ich denke, die Laufzeit spricht für sich.
PS: Kleiner aber feiner Tippfehler im Code:

SELECT	SID_PERSONEN
FROM	(

SELECT	SID_PERSONEN, count(*) 
OVER (PARTITION BY soundex(NAME),soundex(VORNAME),ANREDE) AS x
FROM	PERSONEN

) xx

WHERE	xx.x > 1;

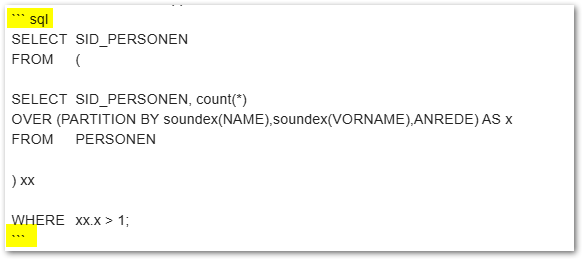
Der Tippfehler war vermutlich gar keiner, sondern in der Markdown-Syntax hat der * eine Sonderbedeutung und führte zu kursiver Schrift bis zum nächsten *.

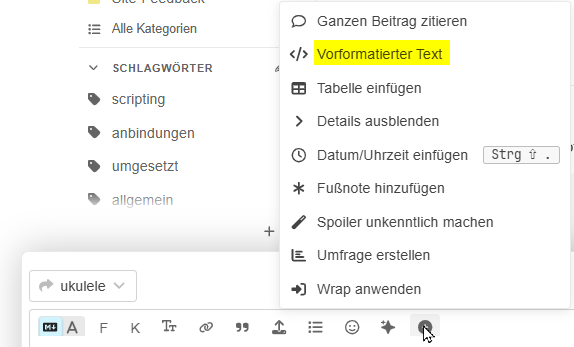
Sie müssten „Code“-Blöcke mit


einfügen. Und wenn Sie nach den 3 „Tickles“ noch sql dahinterhängen, dann versucht sich das Forum auch noch im Syntaxhighlighting für SQL-Syntax. :nerd_face:

(Wurde oben bereits erledigt.)